문서 · 가이드
텍스트 추출·OCR·Markdown 중 무엇을 쓸까
원본의 문자 데이터와 재사용 목적에 따라 읽기 방법을 선택합니다.
편집 책임: SideSideDev
브라우저 로컬 파일 처리 도구를 개발·운영합니다. 합성 예제와 제품의 실제 옵션·출력을 대조합니다. 모든 문서의 호환성이나 원본 편집기와의 동일성을 보증하지 않습니다.
원본에 글자가 있는가
HWP·DOCX 등 문서의 문자 데이터는 해당 형식의 텍스트 추출로 읽습니다. 사진·스캔 PDF처럼 글자가 픽셀에만 있으면 OCR이 필요합니다. 확장자만 보고 문자 데이터가 있다고 단정하지 않습니다.
텍스트 추출은 원본에 없는 글자를 이미지에서 인식하지 않습니다. OCR은 인식 과정에서 오류를 만들 수 있으므로 문자 데이터가 이미 있는 원본을 먼저 사용하는 편이 검수에 유리합니다.
확인할 점
- 원본의 검색·복사를 시험합니다.
- 형식에 맞는 텍스트 추출부터 판단합니다.
값과 구조의 목적
TXT는 본문 재사용에 단순하고 Markdown은 제목·목록·표의 일부 구조를 표현하는 데 적합합니다. HWP의 모든 스타일·도형·쪽 배치를 Markdown이 보존하는 것은 아닙니다.
표의 셀 값을 계산에 쓰려면 표 추출이 적합할 수 있습니다. 그림 추출은 본문과 별도이며 글자 인식이 아닙니다. 한 결과로 모든 목적을 충족시키기보다 필요한 출력 종류를 구분합니다.
확인할 점
- 본문·표·그림 목적을 정합니다.
- 배치 재현과 구조 표현을 구분합니다.
한글 표와 이미지 비교
sample-table.hwp에서 TXT·Markdown·표 추출을 비교합니다. WebOffice Sample과 Item A=10, Item B=20이 어떻게 표현되는지 확인합니다.
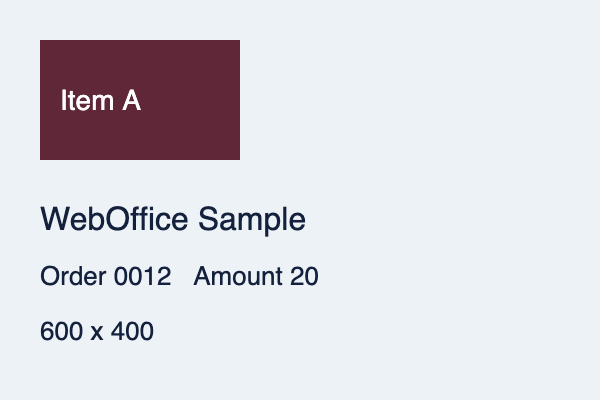
같은 문구가 그림에 있는 sample-image.png는 OCR로 읽어야 합니다. 0012와 20을 직접 대조하고 글자를 읽었다고 원본 표 구조를 복원한 것으로 해석하지 않습니다.
확인할 점
- 표 값은 셀 단위로 대조합니다.
- OCR의 중요 숫자는 수동 확인합니다.
따라 해볼 예제
선명도·기울기에 따른 OCR 실제 결과 대조하기
정답이 있는 한글·영어·숫자 이미지를 선명한 상태와 축소·확대·기울어진 상태에서 인식하고 보정하지 않은 TXT를 비교합니다.
- Order의 0012와 Amount의 20을 원문과 대조합니다.
- O/0·I/1, 날짜의 하이픈과 줄바꿈을 따로 확인합니다.
함께 연습할 공개 합성 파일
아래 자료를 내려받은 뒤 해당 도구에서 직접 선택합니다. 결과를 공유하기 전에 본문 검수 항목과 비교하세요.
형식과 API 참고 자료
- RHWP source and support scope
- Microsoft: Inspect hidden data and personal information
- Tesseract: Improving output quality
일반 형식·API의 출처입니다. 웹오피스의 입력 지원·옵션·결과는 현재 도구 안내와 검수 항목을 기준으로 확인하세요.